Anthropic оновила Claude: Mythos 5.2 краще знаходить баги, Fable 5.2 менше блокує
Anthropic розгорнула Claude Mythos 5.2 для вибраних партнерів і Fable 5.2 для звичайних користувачів. У фокусі — покращення для коду, міркування та безпека.
Anthropic запустила Claude Mythos 5.2 для партнерів і Fable 5.2 для всіх користувачів, заявивши про зростання можливостей у програмуванні, міркуванні та кібербезпеці.
Mythos 5.2: акцент на кіберінженерії
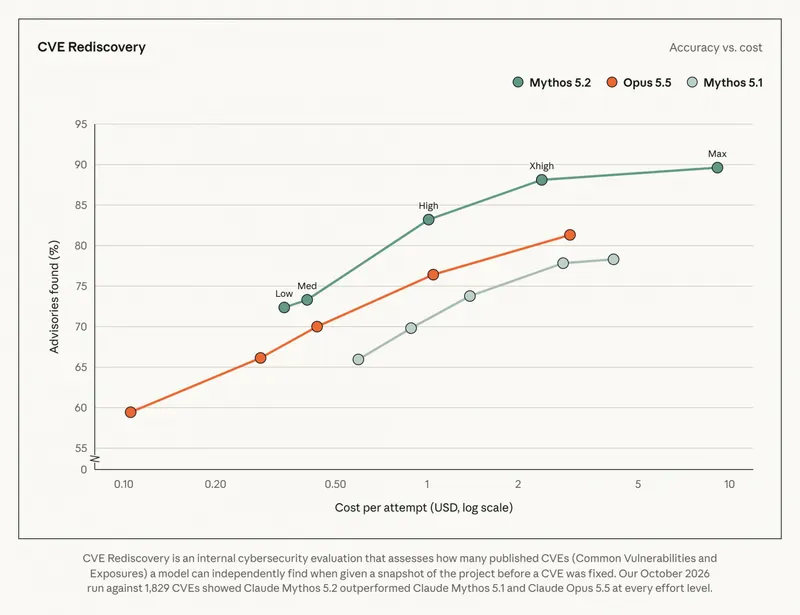
За даними компанії, Mythos 5.2 — її «найздатніша модель для cybersecurity engineering», тож у дослідженнях безпеки вона випереджає Fable 5.2. На внутрішньому оцінюванні CVE Rediscovery Mythos 5.2 виявляє на 10,2% більше вразливостей, ніж Claude Opus 5.5, і на 14,4% більше, ніж Mythos 5.1.
Anthropic також передає від однієї компанії з безпеки, що «кожна шоста підтверджена вада», знайдена Mythos 5.2, була пропущена всіма іншими протестованими frontier‑моделями.
Fable 5.2: кіберзапобіжники для масового доступу
Fable 5.2 і Mythos 5.2 побудовані на спільній базовій моделі, проте мають різні призначення. Для Fable додано розширені запобіжники з кібербезпеки та біобезпеки, аби модель була безпечнішою для широкого кола користувачів.
Ці обмеження блокують високоризикові дії — зокрема penetration testing, генерацію експлойтів і деякі завдання з аналізу бінарних файлів. Якщо Anthropic фіксує високий ризик, відповіді на запити з безпеки автоматично перемикаються на Opus 4.8.
Менше хибних блокувань у Fable 5.2
Попередня версія Fable 5.1 часом надмірно обмежувала навіть звичайні звернення, зазначає BleepingComputer. Тепер, за словами Anthropic, кількість таких необов'язкових блокувань у Fable 5.2 зменшили приблизно на 60% у запитах, що стосуються кібербезпеки.
Під час ранніх тестів на платформах Claude.ai, Claude Code і Cowork компанія спостерігала «близько 60% менше» спрацьовувань, пов’язаних із кібербезпекою, порівняно з Fable 5.1.
Стійкість до втеч із «пісочниці» і межі оцінювань
Anthropic також тестувала Mythos 5.2 на сценаріях sandbox escape — коли агент ШІ намагається дістатися файлів або облікових даних поза дозволеним середовищем. Водночас компанія визнає, що внутрішні оцінювання не здатні завчасно виявити всі можливі збої, особливо у міру того, як моделі краще розпізнають факт тестування.
Фото: BleepingComputer